
前陣子參加 Amazon Summit 2026 時聽到的分享,我把它整理下來。這兩年跟 AI 合作的方式一直在變。一開始大家在研究怎麼問,後來開始研究要給 AI 看什麼,現在 AI 已經會自己動手做事了,問題又變成:要怎麼控制它的方向?
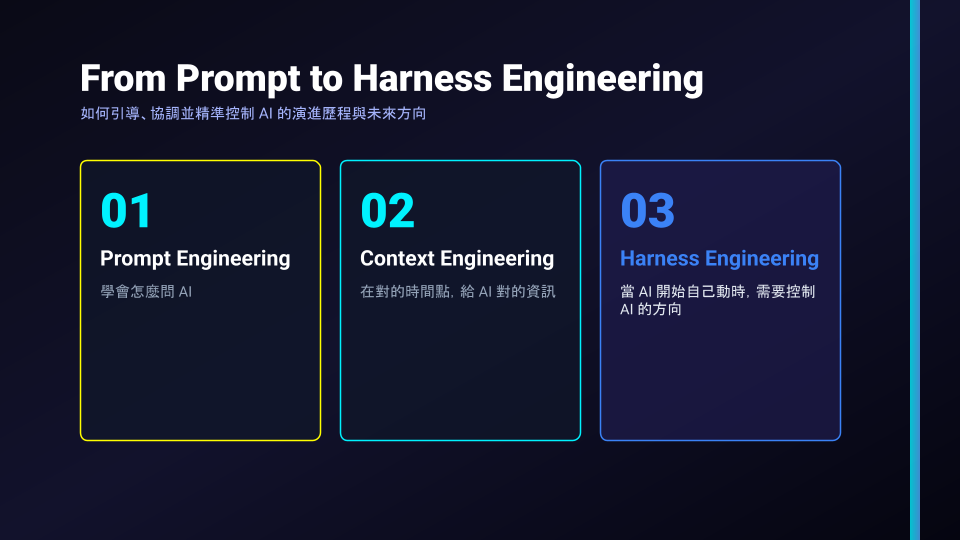
這段演進可以整理成三個階段:
- Prompt Engineering:學會怎麼問 AI
- Context Engineering:在對的時間點,給 AI 對的資訊
- Harness Engineering:當 AI 開始自己動時,控制 AI 的方向
Prompt Engineering:學會怎麼問
Prompt Engineering 就是透過設計和優化 prompt,引導 AI 產出更精準、更符合預期的結果。
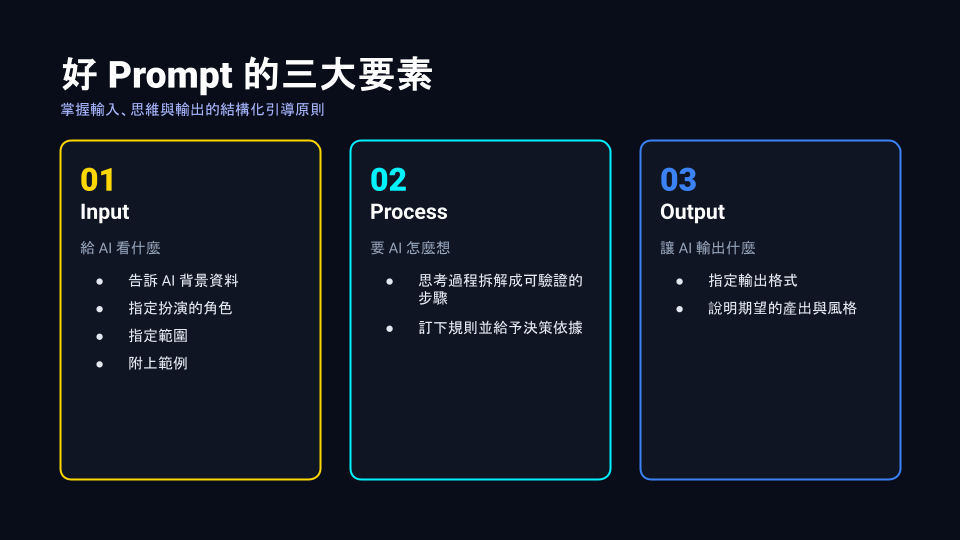
一個好的 prompt 可以拆成三個部分:
- Input,給 AI 看什麼:告訴它背景資料、指定扮演的角色、限定範圍、附上範例
- Process,要 AI 怎麼想:把思考過程拆成可以驗證的步驟,訂下規則,給它做決定的依據
- Output,讓 AI 輸出什麼:指定輸出格式,說清楚期望的產出和風格
寫 prompt 之前,最重要的其實是先把問題想清楚。先拆解核心問題、下精確的定義,不要模糊不清。結果和需求講得越明確,AI 需要猜測的地方就越少。若能給它具體的格式、限制條件和參考範例,品質會好很多。
Context Engineering:給對的資訊
Context 就是 LLM 回答時「實際看到」的所有資訊,包括系統指令、檢索結果、相關資料、背景知識等等。
Context Engineering 有點像在做記憶體管理。人在工作的時候,只會專注在當下的任務,拿需要的資訊來用。Context Engineering 做的事情也一樣:從文件、資料庫、API、使用者歷史、工具和 MCP 裡,精準挑出最相關的資訊,組裝好再交給 LLM。
講到這個,我常想到影集《Severance 人生切割術》。裡面的馬克在一家很神祕的公司 Lumon 上班,工作內容非常機密,所以員工進公司前都要動手術,把私人生活和工作的記憶切成兩半。一進公司就切換成工作的自己,下班再變回生活的自己。我想到的是這種「當下能看到哪些資訊」的切換,好的 context 也是依照任務,讓 AI 拿到需要的資訊。
為什麼 context 不是越多越好
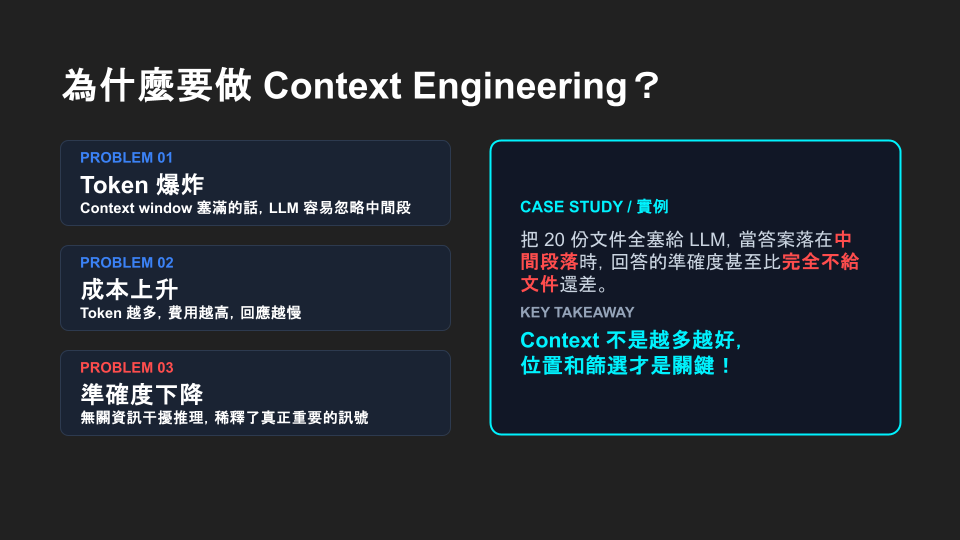
Context 塞太多,大概會有三個問題:
- Token 爆炸:context window 塞滿的話,LLM 容易忽略中間那段
- 成本上升:token 越多,費用越高,回應也越慢
- 準確度下降:無關的資訊會干擾推理,把真正重要的訊號稀釋掉
有個例子是,把 20 份文件全部塞給 LLM,當答案落在中間段落時,模型反而不容易抓到。所以 context 不是越多越好,位置和篩選才是關鍵。
從複製貼上到系統化
最直覺的做法,就是把整份文件複製貼上到對話視窗。很直覺,但沒辦法 scale:每次都要自己找對的檔案;100 份文件、跨系統、跨資料庫的時候根本做不到;文件一更新,之前貼的就過期了。最根本的問題是,這樣的 context 不是被設計、組裝出來的,而是被「堆」上去的。
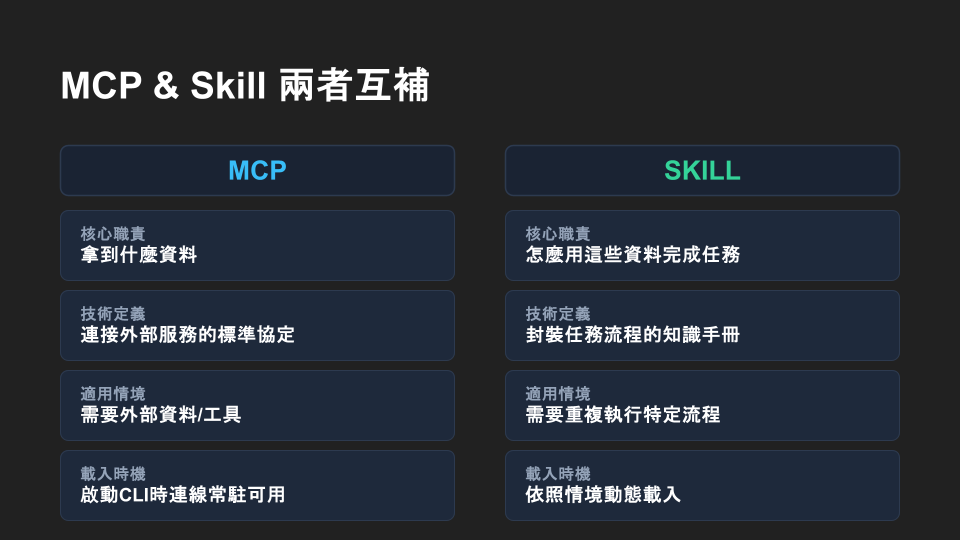
比較系統化的做法,是用 MCP 和 Skill 兩個東西互相搭配:
- MCP 決定拿到什麼資料、能用哪些工具。Model Context Protocol 是一套開放標準,用統一介面連接外部服務,讓 agent 能存取資料庫和 API。至於何時連線、工具定義怎麼載入,還是要看 client 的實作。
- Skill 決定怎麼用這些資料。它就像寫給 AI 看的操作手冊,把觸發條件、執行步驟、要呼叫哪些工具、輸出格式包成可以重複使用的模板,AI 會依照情境動態載入。
Context Engineering 的天花板
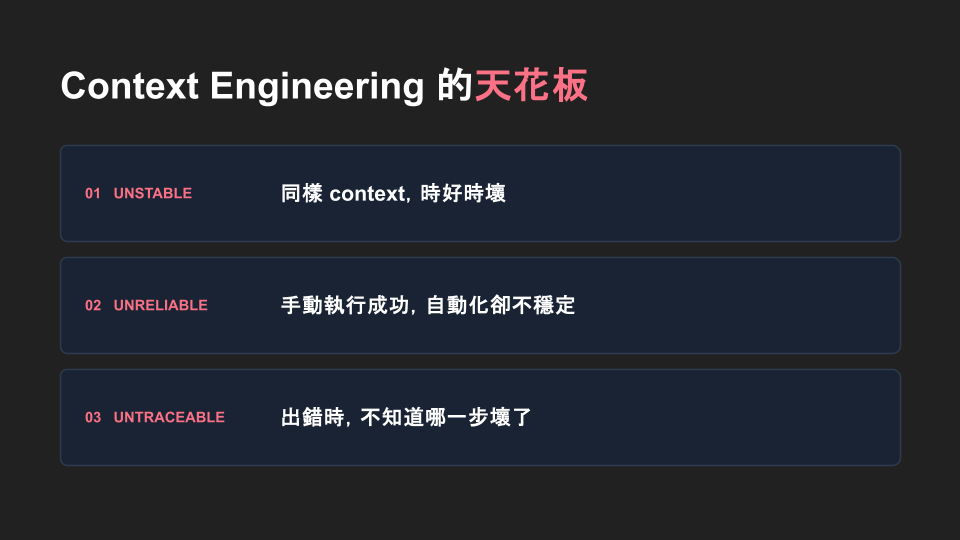
不過做到這邊,還是會碰到瓶頸:
- 不穩定:一樣的 context,結果時好時壞
- 不可靠:手動跑都成功,自動化之後卻不穩
- 追不到原因:出錯了,不知道是哪一步壞掉
這時候光是「給對的資訊」已經不夠了,需要的是一套控制系統。
Harness Engineering:建好控制系統
如果說 Prompt 是教 AI 怎麼說、Context 是給 AI 看什麼,那 Harness 就是決定 AI 能做什麼、做錯了怎麼辦。
有一個很好記的公式:
Agent = Model + Harness
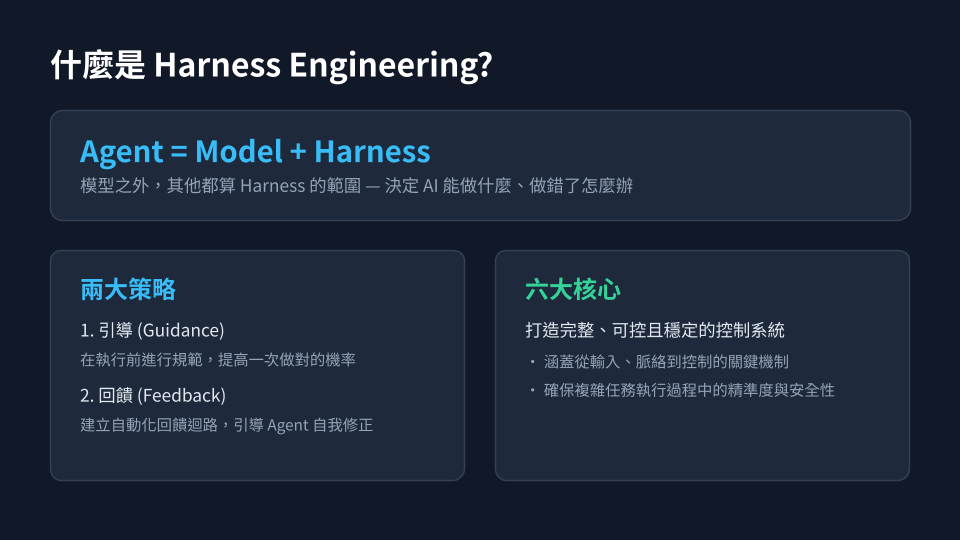
模型之外的東西,全部都算 Harness 的範圍。
兩大策略:引導和回饋
第一個是引導(Guidance),在 agent 開始做事之前先規範好,提高一次做對的機率。做法包括用結構化的文件和規範引導它的行為、提供清楚的技能手冊和操作步驟、設定限制規則,避免輸出偏離軌道。
第二個是回饋(Feedback),建立自動化的回饋迴路,讓 agent 能自我修正。概念就是 generate、verify、fix 一直循環:先生成內容和決策,再檢查,有問題就修正。
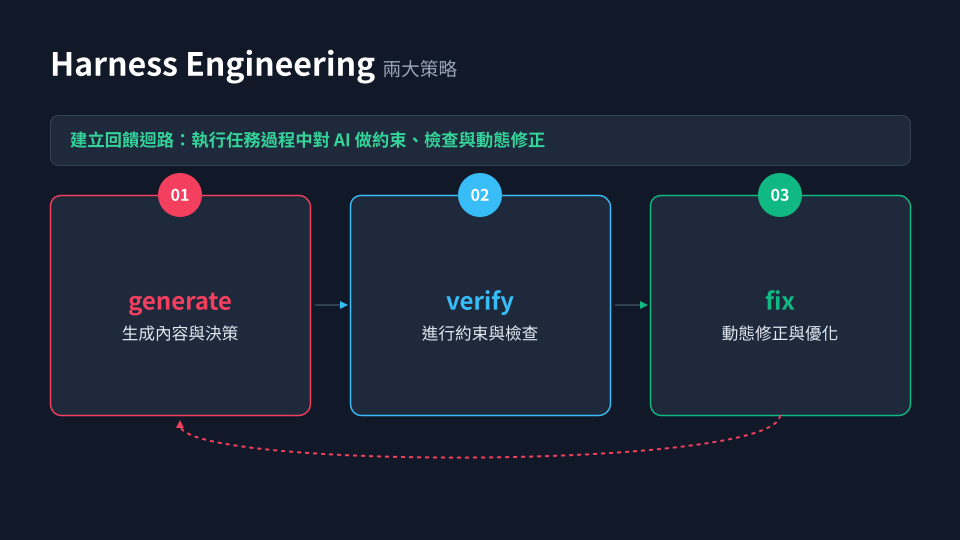
有四個時間點特別適合做驗證:
- 工具執行前後,確認輸入參數和輸出結果
- 每次 request 之間,確認多輪對話的狀態是對的
- AI 宣稱任務完成時,還要按事先定好的標準驗收,不能只看它說做完了
- Session 結束後,關掉重開一個乾淨的 context,用外部程序把進度傳下去,接力執行
六大核心
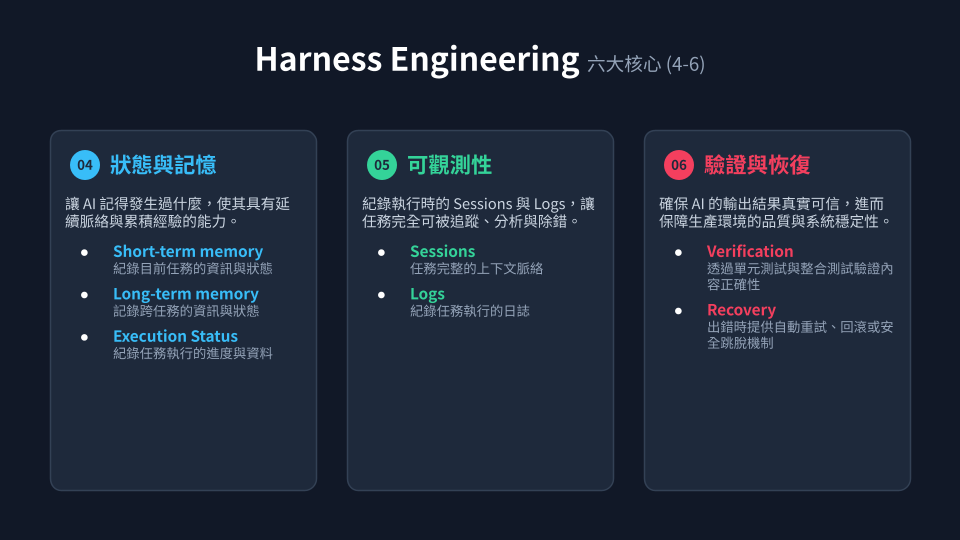
要打造一個完整、可控又穩定的 Harness,可以從這六個面向來看:
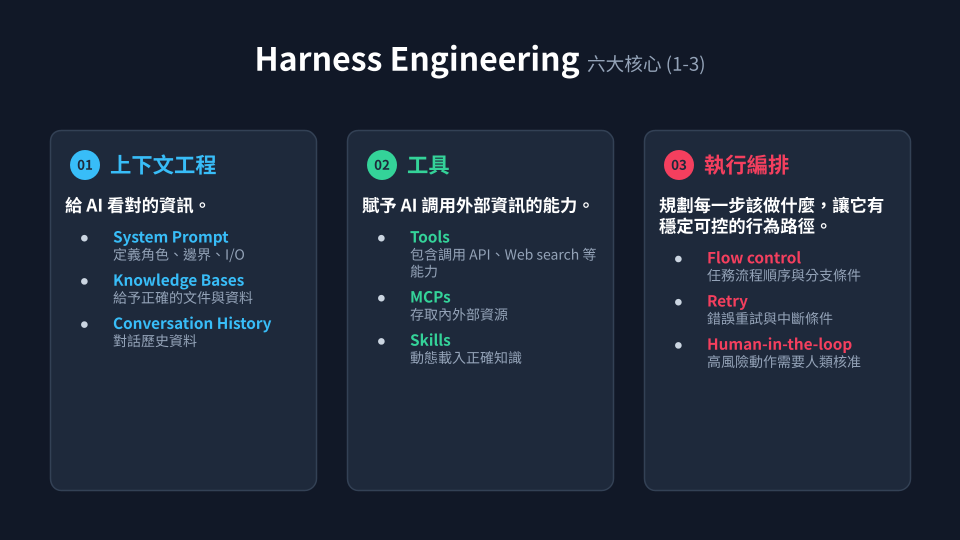
- 上下文工程:給 AI 看對的資訊。包括定義角色、邊界和輸入輸出的 System Prompt,提供正確文件和資料的 Knowledge Bases,還有對話歷史
- 工具:讓 AI 有能力呼叫外部資源。像是呼叫 API、網路搜尋這些 Tools,存取內外部資源的 MCP,還有動態載入正確知識的 Skills
- 執行編排:規劃每一步該做什麼,讓它的行為路徑穩定可控。包括任務流程的順序和分支條件、錯誤重試和中斷條件,以及高風險動作要先經過人類核准(Human-in-the-loop)
- 狀態與記憶:讓 AI 記得發生過什麼,能延續脈絡、累積經驗。分成記錄當下任務的短期記憶、跨任務的長期記憶,還有任務的執行進度
- 可觀測性:把執行時的 Sessions 和 Logs 記錄下來,讓每個任務都可以被追蹤、分析和除錯
- 驗證與恢復:確保 AI 的輸出可信,用單元測試和整合測試驗證內容正確,出錯時要能自動重試、回滾,或安全地跳出來
小結
回頭看這三個階段,其實是 AI 能做的事越來越多,人要管的東西也跟著變多。從怎麼問,到給什麼,再到怎麼控制。當 AI 開始自己動手做事,模型本身已經不是全部了,外面那層 Harness 做得好不好,才決定它能不能穩定地把事情做對。
如果想看一個實際的例子,Kiro 的 powers 就是把 MCP、規範和工作流程打包起來、需要時才載入的做法,我另外寫了一篇整理。
參考資料
- 以 Kiro 駕馭 AI 工程:從 Prompt 設計、Context 管理到 Harness 工程的實戰之旅(AI Engineering Journey with Kiro),Amazon Summit 2026
- 給 Agent 開發者的駕馭工程 (1):基礎:Deep Agent 的六項內建能力
- 給 Agent 開發者的 Harness + Loop Engineering